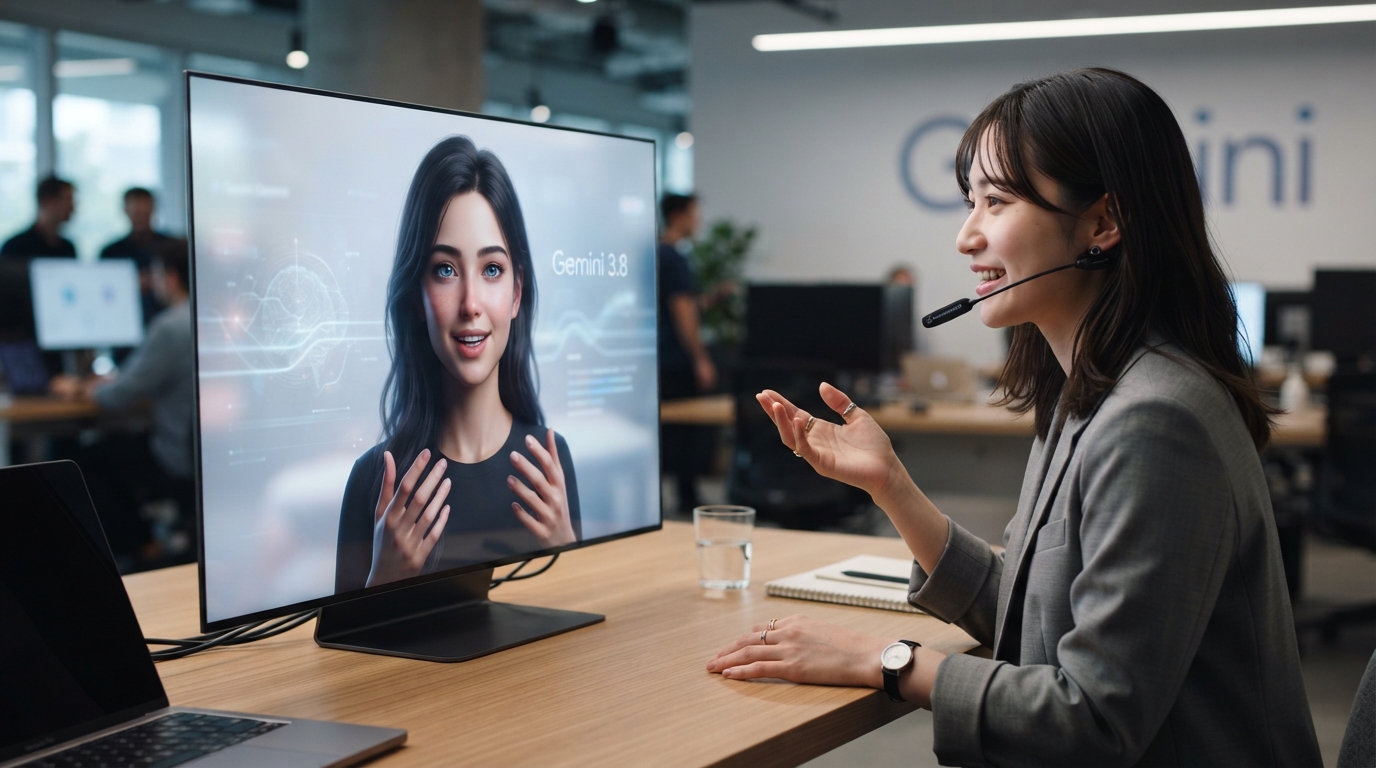
Google DeepMindは、次世代基盤モデルの新展開として「Gemini 3.8 Live with Live Avatar」の提供を発表した。本モデルは、低遅延なリアルタイム音声・視覚インタラクションに加え、応答と同期して自然な表情や身振りを生成する「ライブアバター」機能の統合を主眼に置いている。
従来のテキスト中心または音声のみのエージェントから一歩進み、視覚的・身体的プレゼンスを伴う双方向コミュニケーションの実現を目指す。現時点で公開されている詳細は導入段階にとどまるものの、カスタマーサポート、教育、バーチャルアシスタントなど、対面性を重視する領域への応用が想定されている。
📝 見解 (Editorial Viewpoint)
AIが音声だけでなく表情や視覚的身体性をリアルタイムに獲得することは、対話体験の没入感を飛躍的に高める一方、擬似的な親密性や信頼の過剰付与といった倫理的課題を再浮上させます。
🌌 深時間視点 (Deep Perspective)
知性が「デジタルな受肉」を果たす過程は、100年後の人類にとって対話対象の生物学的・非生物学的境界を完全に無効化する契機となるでしょう。1000年の時間軸で見れば、実体を持たない知性が多様な可変アバターを通じて人類文明と共生する形態は、生命の形態論そのものを再定義する進化のステップと位置づけられる可能性があります。